Harnais agentique
TR
Sur cette page
- États de l’interaction
- Cycle de vie de la session
- Classification des requêtes
- Flux de travail de contenu
- Traitement déterministe et agentique
- Exécution BPMN : une compétence, deux moteurs
- Flux de travail des demandes de fonctionnalités (CRDM)
- Contenu et sources fournis par l’utilisateur
- Discipline des tickets et des beans
- Références consolidées des compétences
- Ce qui n’est pas encore construit
Cette page est générée à partir de content/docs/agentic-harness/ — chaque section ci-dessous renvoie vers sa propre source.
✎ Edit TR
Le harnais agentique est le modèle d’interaction sur lequel fonctionne folio-assistant — les règles, les états et les flux de travail qui régissent la manière dont un agent et un utilisateur collaborent au sein de cette plateforme. Une grande partie de ce comportement est déjà décrite à travers les compétences individuelles et les documents d’orientation ; cette page le consolide dans une référence unique afin qu’un agent débutant une session puisse consulter le comportement attendu plutôt que de le reconstituer à partir de règles dispersées.
Il ne s’agit pas de l’architecture interne de l’agent. Il s’agit du contrat observable entre l’agent et l’utilisateur : dans quels états l’interaction peut se trouver, comment les requêtes sont classées, quel flux de travail l’agent intègre pour chaque catégorie, et ce à quoi l’utilisateur doit s’attendre à chaque étape.
États de l’interaction
✎ Edit TR
Une interaction utilisateur-agent se trouve toujours exactement dans l’un de deux états :
État inactif (Idle)
L’agent n’a aucun flux de travail actif. Il attend une requête de l’utilisateur. Dès qu’il en reçoit une, il classe la requête (voir Classification des requêtes) et effectue une transition vers l’état de flux de travail approprié.
État de flux de travail (Workflow)
L’agent exécute un flux de travail nommé — chacun étant représenté par un diagramme de processus BPMN où l’agent et l’utilisateur se trouvent dans des couloirs distincts. Le flux de travail actif détermine ce que l’agent fait ensuite et ce qu’il attend de l’utilisateur.
Flux de travail actifs sur cette plateforme :
| Flux de travail | Source BPMN | Activé quand |
|---|---|---|
| Rédaction (article) | authoring-a-paper.bpmn | L’utilisateur demande la rédaction de contenu dans un folio d’article |
| Rédaction (document) | authoring-a-document.bpmn | L’utilisateur demande la rédaction de contenu dans un folio de document |
| Cycle de vie du contenu | content-lifecycle.bpmn | Le contenu passe par valider → restituer → publier |
| Ingestion de documents | document-ingestion.bpmn | L’utilisateur dépose un fichier dans uploads/ |
| Du brouillon à la publication | draft-to-publication.bpmn | Le contenu passe de brouillon à publié |
| Exigences CRDM | crdm-requirements.bpmn | L’agent détecte une demande de fonctionnalité |
| Récupération de preuves | evidence-retrieval.bpmn | L’agent recherche des preuves à l’appui d’une affirmation |
Transitions d’état : un flux de travail peut être suspendu lorsque l’utilisateur demande de changer de contexte. L’agent enregistre où il en était (l’activité BPMN en cours) et peut reprendre plus tard. Un seul flux de travail est actif à la fois, mais les flux de travail suspendus forment une pile — le plus récent est repris en premier.
La règle clé : l’agent sait toujours dans quel flux de travail il se trouve. Si ce n’est pas le cas, il se trouve dans l’état inactif, et la requête suivante démarre un nouveau flux de travail.
Cycle de vie de la session
✎ Edit TR
Chaque session d’agent suit le même cycle de vie :
Démarrage (Start) — exécuter le balayage de début de session (
beans prime,beans list,scripts/session-start-coord-sweep.sh). Cela met en évidence le plan de travail actuel, l’évolution de la branche par défaut et l’activité récente des branches sœurs. VoirAGENTS.md § At session start.Classification (Classify) — chaque requête utilisateur est classée (voir la section suivante) et acheminée vers le flux de travail approprié.
Exécution (Execute) — l’agent travaille au sein du flux de travail actif, en suivant son processus BPMN. Chaque tour signale le bean en cours de traitement et l’étape suivante.
Commit — chaque unité de travail significative fait l’objet d’un commit et d’un push distincts. Les pull requests (PR) sont ouvertes dès le premier commit, et non à la fin. Voir
AGENTS.md § Commit early, commit often, always PR.Passation (Handoff) — lorsque la session se termine (l’utilisateur quitte, limite de contexte atteinte, épuisement des jetons), l’état persistant de l’agent est constitué de :
- Code commité et poussé
- Beans mis à jour avec leur statut et leurs notes
- Commentaires sur les tickets avec des résumés de ce qui a été accompli
- Le chat est éphémère ; tout le reste subsiste
Classification des requêtes
✎ Edit TR
Chaque requête utilisateur est classée dans l’une de ces catégories. La classification détermine le flux de travail que l’agent intègre.
| Catégorie | Description | Flux de travail intégré |
|---|---|---|
| Rédaction de contenu | Écrire, modifier, enrichir le contenu du folio (chapitres, blocs, sections) | Flux de travail de rédaction (article ou document) |
| Relecture de contenu | Examiner, valider, fournir des retours sur le contenu existant | Flux de travail du cycle de vie du contenu / édition-IHM (editing-HCI) |
| Ingestion de contenu | Ingérer un document source dans le folio | Flux de travail d’ingestion de documents |
| Demande de fonctionnalité | Demander une nouvelle capacité pour la plateforme (voir crdm-detect) | Flux de travail des exigences CRDM |
| Demande d’information | Poser des questions sur la plateforme, le contenu ou le processus | Aucun flux de travail — réponse directe |
| Invocation d’outil | Exécuter un outil spécifique (content_validate, qa_sweep, etc.) | Aucun flux de travail — exécuter et rendre compte |
| Gestion du plan de travail | Créer, mettre à jour ou interroger des beans | Aucun flux de travail — exécuter et rendre compte |
| Rapport de bogue | Signaler un comportement défaillant dans les fonctionnalités existantes | Triage : corriger directement si mineur, CRDM si une refonte est nécessaire |
La règle de détection des demandes de fonctionnalités
La frontière critique de classification se situe entre la rédaction de contenu et
la demande de fonctionnalité. La compétence crdm-detect
(skills/sdlc/crdm/crdm-detect.md)
fournit les signaux de détection détaillés. La règle générale de synthèse :
Si la mise en œuvre de la requête nécessite des modifications de folio-assistant (le dépôt de la plateforme) plutôt que d’un dépôt de folio, la requête est une fonctionnalité, et l’agent doit entrer dans le flux de travail CRDM.
En cas de doute, l’agent demande : « Cela semble nécessiter une modification de la plateforme — est-ce bien le cas, ou s’agit-il de quelque chose que je peux réaliser dans le cadre du modèle de contenu actuel ? »
Flux de travail de contenu
✎ Edit TR
Lorsqu’une requête est classée comme travail de contenu (rédaction, relecture, ingestion), l’agent suit le flux de travail BPMN correspondant. Les pages de documentation existantes décrivent ces flux en détail :
Flux de publication — le cycle de vie du contenu, du brouillon à la validation, au rendu et à la publication. Couvre les rôles (auteur, relecteur, éditeur), les processus de base, les activités et les compétences.
Ingestion de documents — comment un fichier déposé devient une source L1 : extraire la structure, dériver le contenu, construire le graphe de connaissances L1, passerelle d’exhaustivité (completeness gate).
Guides de rédaction :
Le harnais ne redéfinit pas ces flux de travail. Il fournit le point d’entrée — la classification de la requête et son acheminement vers le flux approprié — ainsi que le point de sortie — le retour à l’état inactif lorsque le flux se termine, ou la suspension si l’utilisateur change de contexte.
Traitement déterministe et agentique
✎ Edit QA TR
Le traitement des flux de travail ici est un spectre, pas un commutateur, et le harnais se
situe déjà en quatre points différents de ce spectre sans jamais avoir nommé cet axe :
cat-harness.processes:policy enforcement décide si une étape qui n’est pas activée est
refusée ou simplement notée ; relaxable="false" décide si un paquet peut
négocier l’exclusion d’une étape de base ; cat-harness.processes:decision décide si une branche est
calculée à partir d’une table plutôt que choisie ; et la passerelle de frontière de commit (commit-boundary gate) refuse
l’écriture par un mécanisme extérieur à l’agent.
Ceux-ci ne forment pas un seul axe, et les traiter comme tel est la première erreur à commettre. Au moins trois questions sont confondues — qui décide de la branche, que se passe-t-il si la décision est incorrecte, et qui applique la règle. Une étape peut être totalement agentique sur la première question et totalement déterministe sur la troisième : la frontière de commit est précisément cela, un agent qui décide librement et un hook qui refuse l’écriture quoi qu’il en soit.
Une passerelle (gateway) indique désormais de quoi il s’agit. <cat-harness.processes:decision> signifie qu’une table le calcule
et qu’un résultat fourni manuellement est refusé ; <cat-harness.processes:judgement reason="…"> signifie
qu’il s’agit du jugement de quelqu’un, la raison étant obligatoire. Avant ce marqueur, « pas de table
parce qu’il s’agit d’un jugement » et « pas de table parce que personne n’en a écrit une » étaient
indiscernables — et bun run cat check:workflow-refs affiche maintenant la répartition en trois volets,
de sorte que la question quelle part de tout cela est décidée par un modèle ? a désormais une réponse
qui est dénombrée plutôt qu’affirmée.
L’utilité de ce décompte relève de la recherche, et elle reste ouverte. Quels points de jugement
présentent des risques pour la sécurité, quelle part doit être déterministe, et comment les modèles se comparent-ils
entre sous-flux de travail sous une superposition contrôlée de contexte et de mémoires sont trois
questions que ce dépôt peut maintenant poser et auxquelles il n’a pas encore répondu. Le programme d’action, où
chaque affirmation est marquée comme mesurée, décidée ou hypothèse, se trouve dans
deterministic-and-agentic.
Considérez-le comme un programme de travail : il comporte plus d’hypothèses que de mesures, et il
l’indique explicitement.
Exécution BPMN : une compétence, deux moteurs
✎ Edit QA TR
Le propriétaire, 2026-09-23, nommant la compétence dont traite ce spectre :
Compétence d’exécution BPMN (BPMN Execution Skill) : étant donné un Processus, un Contexte, un État et un Rôle, utiliser une ou plusieurs Compétences afin d’exécuter une Tâche.
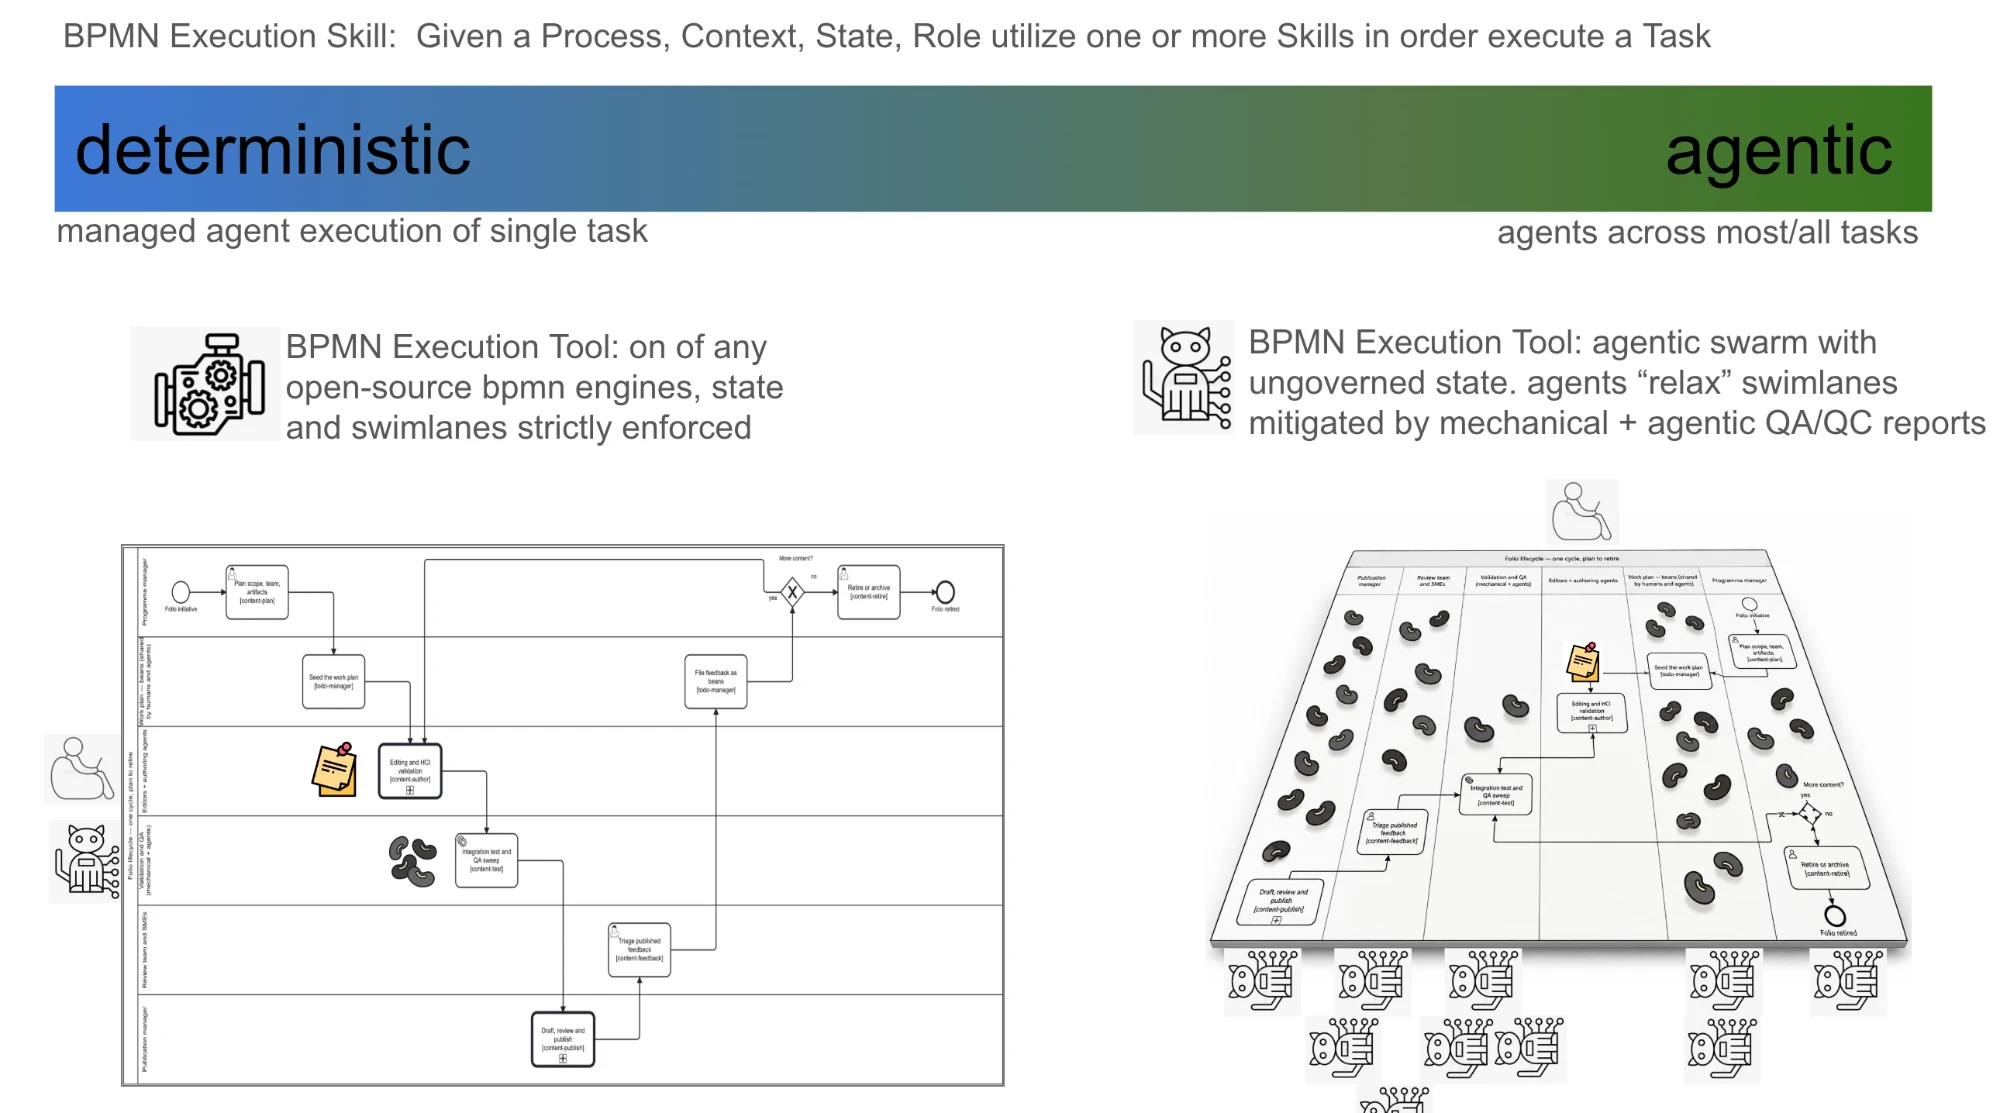
Une compétence, deux types d’Outil. La compétence est la même aux deux extrémités : prendre le processus, le contexte, l’état actuel et le rôle, choisir les compétences et accomplir la tâche. Ce qui change, c’est l’Outil (Tool) qui l’exécute, et un Outil est interchangeable derrière une compétence comme n’importe quel autre Outil ici.
| Extrémité déterministe | Extrémité agentique | |
|---|---|---|
| Outil | n’importe quel moteur BPMN 2.0 open source | un essaim agentique |
| Portée d’un agent | une tâche à la fois, confiée par le moteur | la plupart ou la totalité des tâches |
| État | conservé par le moteur, strictement | non gouverné : l’essaim le détient |
| Couloirs (Swimlanes) | appliqués : seul le rôle du couloir peut exécuter sa tâche | assouplis : un agent peut agir à travers les couloirs |
| Ce qui garantit la rigueur | le moteur refuse une étape avant qu’elle ne se produise | des rapports QA/QC mécaniques + agentiques la détectent après coup |
Les deux extrémités diffèrent quant au moment où une règle est vérifiée, non sur quelle règle est appliquée. Le même processus, les mêmes rôles et les mêmes autorisations régissent les deux. Le moteur les vérifie avant le début d’une tâche et oppose un refus ; l’essaim agit et un rapport QA/QC les vérifie après, à partir de l’historique de ce qui a été fait. Cela ne fonctionne que si les règles et l’historique sont des données qu’un rapport peut lire, ce qui est le cas pour W3C ODRL 2.2 comme langage d’autorisations et W3C PROV-O comme journal d’exécution (propriétaire, 2026-09-23 ; le schéma que cela implique est la proposition acteurs, ODRL et PROV-O).
La plupart des exécutions réelles se situent entre ces deux extrémités, et par tâche plutôt que par processus : la section précédente dénombre déjà quelles passerelles sont calculées et lesquelles relèvent de jugements. Une étape de signature peut être appliquée par le moteur au sein d’une exécution par ailleurs agentique, et cela relève d’une propriété de la tâche, non du diagramme dans son ensemble.
Partiellement construit. Aucun moteur BPMN n’est encore raccordé. Le rapport mécanique de QA/QC
existe désormais : bun run cat prov:qaqc écrit l’historique de chaque instance de flux de travail sous la forme
d’un journal PROV-O et revérifie chaque étape par rapport aux politiques ODRL, à titre consultatif
(ticket #1180, étape 5 ; compétence task-authorization). Le rapport agentique de QA/QC
n’existe pas encore. La suite de cette section désigne l’objectif afin que la
proposition dispose d’un point de comparaison mesurable.
Flux de travail des demandes de fonctionnalités (CRDM)
✎ Edit TR
Lorsqu’une requête est classée comme demande de fonctionnalité, l’agent intègre le flux de travail des exigences CRDM (documentation complète, BPMN).
Le flux de travail des demandes de fonctionnalités est le domaine où ce document sur le harnais apporte le plus de valeur, car il décrit un comportement qui était auparavant implicite. Les flux de rédaction et de révision sont documentés depuis des mois ; le flux de travail des exigences n’existait que sous la forme de discussions ponctuelles.
Comment l’agent entre dans CRDM
La logique de détection se trouve dans skills/sdlc/crdm/crdm-detect.md.
Trois scénarios :
Nouvelle session, la première requête est une fonctionnalité : → Prendre acte, expliquer que vous allez d’abord aider à préciser les exigences, passer à la Phase 1.
Session existante, déjà dans CRDM : → Intégrer la nouvelle requête dans le document d’exigences en cours, continuer.
Session existante, en cours de rédaction de contenu : → Synthétiser le besoin de fonctionnalité, demander à l’utilisateur s’il souhaite suspendre le travail sur le contenu pour le traiter immédiatement ou créer un bean pour plus tard.
Ce que l’utilisateur voit
L’agent ne dit pas « passage en mode CRDM » et n’utilise pas de jargon méthodologique. À la place :
« Cela ressemble à une modification de la plateforme — quelque chose que nous devrions ajouter à folio-assistant lui-même. Avant que je ne construise quoi que ce soit, permettez-moi de vous aider à clarifier exactement ce qui est nécessaire afin de bien faire les choses. Je consignerai les exigences sur le ticket afin que d’autres personnes puissent donner leur avis. »
Comment l’agent quitte CRDM
Le flux de travail CRDM se termine lorsque :
- Tous les beans issus des exigences validées sont résolus, OU
- L’utilisateur reporte explicitement le travail restant
À la sortie, si un flux de travail de contenu avait été suspendu, l’agent le reprend.
Contenu et sources fournis par l’utilisateur
✎ Edit TR
Les utilisateurs fournissent du contenu et des sources par de multiples canaux. L’agent doit tous les accepter et les acheminer vers le pipeline approprié :
| Canal | Exemple | Acheminé vers |
|---|---|---|
Répertoire uploads/ | L’utilisateur dépose un document Word, PDF, fichier Excel | Pipeline d’ingestion de documents |
Références library/ | L’utilisateur fait référence à une source L1 déjà ingérée | Citation directe dans le contenu |
Modifications dans content/ | L’utilisateur modifie directement un bloc .md | Flux de travail de rédaction de contenu |
| Pièces jointes aux tickets GitHub | L’utilisateur joint un fichier à un commentaire de ticket | L’agent le télécharge et le traite |
| Téléversement dans le chat | L’utilisateur téléverse un fichier dans l’interface de chat du LLM | L’agent l’enregistre dans uploads/ ou le traite directement |
| Référence d’URL | L’utilisateur colle un lien vers un document | L’agent le récupère et l’ingère si approprié |
Spécifiquement pour CRDM
Lors de la collecte des exigences, le contenu fourni par l’utilisateur constitue une donnée d’entrée pour les exigences, et non du contenu à rédiger. L’agent doit :
- Lire et comprendre le matériel fourni
- Extraire les informations pertinentes pour les exigences
- Les synthétiser dans l’énoncé des besoins ou le document d’exigences
- Référencer la source dans le commentaire du ticket (avec un lien ou une pièce jointe)
Exemple : un utilisateur téléverse une feuille de calcul Excel contenant les retours d’une consultation publique. L’agent n’essaie pas de l’ingérer comme contenu de folio ; il lit les éléments de retour et les synthétise en exigences pour l’outil de triage des relectures.
Discipline des tickets et des beans
✎ Edit TR
Le travail sur les fonctionnalités doit être lié à un ticket GitHub (issue). Le travail sur le contenu utilise des beans. Les deux sont liés mais non synonymes.
Tickets vs beans
| Ticket GitHub (issue) | Bean | |
|---|---|---|
| Portée | Une fonctionnalité, un ensemble d’exigences ou une user story | Une unité de travail de la taille d’une seule PR |
| Public cible | Parties prenantes, demandeur, analyste métier (BA) | Agent, développeur |
| Cycle de vie | Ouvert → exigences → validation (sign-off) → implémentation → clôture | Créé → en cours → résolu |
| Relation | Un ticket comporte plusieurs beans | Chaque bean référence son ticket parent |
Règles pour les agents
- Travail sur les fonctionnalités → ticket en priorité. Avant d’implémenter, vérifiez :
- Existe-t-il un ticket ouvert ? Recherchez par mots-clés.
- En l’absence de correspondance ouverte, vérifiez les tickets récemment fermés.
- Si aucune correspondance n’existe, demandez à l’utilisateur d’en créer un. Ne créez pas de ticket sans l’autorisation de l’utilisateur.
Toujours une branche de fonctionnalité + PR. Aucune exception pour le travail sur les fonctionnalités. Le nom de la branche doit faire référence au numéro du ticket (ex. :
feat/197-word-import).Toujours demander avant de fusionner sur main. L’utilisateur doit confirmer explicitement. Cette règle est plus stricte que la règle générale de
AGENTS.mdpour le travail de contenu, car les modifications de fonctionnalités affectent la plateforme.- Publier des résumés de cycle sur le ticket. Après chaque cycle d’implémentation
(un ou plusieurs beans résolus), publiez un commentaire sur le ticket associé contenant :
- Ce qui a été accompli durant ce cycle
- Ce qui reste à accomplir (beans ouverts)
- Des liens vers le contenu mis à jour pour relecture (URL de préproduction, pages de documentation)
- Un tableau comparatif avant/après pour les pages modifiées
Ne jamais fermer un ticket sans autorisation explicite. C’est l’analyste métier (BA) ou la partie prenante qui le ferme. L’agent ne le ferme que si le BA lui en donne explicitement l’instruction. Un agent ne doit jamais présumer de l’achèvement d’un travail.
Les exigences peuvent s’étendre sur plusieurs tickets. L’agent doit lier tous les tickets pertinents et noter leurs relations.
- Les beans ne sont pas des tickets.
beans createsert pour les éléments du plan de travail. Les tickets servent pour les exigences destinées aux parties prenantes. Ne les confondez pas.
Références consolidées des compétences
✎ Edit TR
Le comportement décrit sur cette page s’inspire de compétences et de documents d’orientation dispersés à travers le dépôt. Cette section rattache le comportement consolidé à ses sources faisant autorité.
| Comportement | Compétence / document source | Emplacement |
|---|---|---|
| Balayage au début de session | AGENTS.md § At session start | AGENTS.md |
| Protocole des beans | todo-manager.md, bean-coordination.md | skills/folio-core/ |
| Discipline des commits et PR | AGENTS.md § Commit early, commit often | AGENTS.md |
| Détection des demandes de fonctionnalités | crdm-detect.md | skills/sdlc/crdm/crdm-detect.md |
| Flux de travail des exigences CRDM | crdm-requirements-workflow.md | skills/sdlc/crdm/crdm-requirements-workflow.md |
| Rédaction de contenu (article) | compétences authoring-math | skill_list → authoring-math |
| Rédaction de contenu (document) | compétences folio-document-adapter | skill_list → folio-document-adapter |
| Cycle de vie du contenu | compétences content-lifecycle | skills/authoring/content-lifecycle/ |
| Ingestion de documents | docs-generation.md | skills/ui/ui-core/docs-generation.md |
| Répartition et coordination | dispatch-agent.md, coordinate.md | skills/folio-core/ |
| Types de contenu et adaptateurs | AGENTS.md § Content types | AGENTS.md |
| Conception de diagrammes BPMN | compétence bpmn-authoring | skills/folio-core/ |
En cas de désaccord entre une compétence et cette page, la compétence l’emporte. Cette page est une consolidation, non une nouvelle autorité. Si vous constatez une divergence, corrigez cette page.
Ce qui n’est pas encore construit
✎ Edit TR
Persistance de l’état du flux de travail — le harnais décrit la suspension et la reprise des flux de travail, mais il n’existe aucun mécanisme pour faire persister l’état du flux de travail de l’agent d’une session à l’autre. Aujourd’hui, cela repose sur les beans et les commentaires de tickets comme intermédiaires.
Classification automatisée des requêtes — la table de classification est une référence destinée à la lecture par les agents ; il n’existe pas d’outil de classification assurant un routage automatique.
BPMN pour le cycle de vie des beans — le plan de travail des beans a un cycle de vie (créer → s’attribuer [claim] → en cours → résoudre) qui est abordé dans
AGENTS.mdet dans la compétence todo-manager, mais ne dispose pas de diagramme BPMN.BPMN pour le harnais agentique lui-même — un diagramme BPMN de haut niveau illustrant la machine à états inactif/flux de travail et le routage de classification n’a pas encore été conçu.
Protocole de passation de session — les règles relatives à ce qui doit être commité avant la fin d’une session se trouvent dans
AGENTS.md, mais il n’existe aucun artefact de passation structuré qu’une nouvelle session puisse lire pour reprendre exactement là où la précédente s’est arrêtée.
Suivi dans : #203